Die Methode des Long Range Forecast Systems (LRFS)
Einblick in Daten, statistische Verfahren und die Berechnung langfristiger Witterungstendenzen.Wie aus großräumigen
Wetter- und Klimadaten langfristige
Witterungstendenzen abgeleitet werden
1. Grundidee und
Entwicklung
Die Witterung in Mitteleuropa wird nicht allein
durch die Wetterlage unmittelbar vor Ort bestimmt.
Auch großräumige Strömungs- und Druckverhältnisse
sowie Vorgänge in anderen Teilen der Erde können mit
der späteren Witterung in Europa statistisch
zusammenhängen. Ein bekanntes Beispiel ist die
Nordatlantische Oszillation (NAO), die vereinfacht
das Druckgefälle zwischen dem Raum um Island und dem
subtropischen Atlantik beschreibt und die
Westwindzirkulation über dem Nordatlantik
beeinflussen kann.
Ausgangspunkt des LRFS war die Untersuchung, ob
Druckanomalien im Nordatlantik – also Abweichungen
des Luftdrucks vom jeweiligen klimatologischen
Mittel – statistische Hinweise auf die
Temperaturentwicklung in Mitteleuropa in den
folgenden Monaten enthalten. Da solche Beziehungen
nicht zu jeder Zeit gleich stark ausgeprägt sind,
wurde die Analyse auf weitere Gebiete der
Nordhemisphäre ausgeweitet, darunter den
Nordpazifik, Eurasien und Nordamerika. Zusätzlich
zum Luftdruck wurden weitere meteorologische Größen
einbezogen: das Geopotential in der
200-hPa-Druckfläche sowie die Oberflächentemperatur
der Weltmeere.
Auf dieser Grundlage entstand das statistische
Verfahren LRFS (Long Range Forecast System). Die
Berechnungen wurden ab 2004 schrittweise
automatisiert und in den folgenden Jahren mehrfach
überarbeitet. Der aktuell beschriebene
Untersuchungszeitraum reicht von 1966 bis 2025. Die
Automatisierung ermöglicht es, umfangreiche
Datensätze systematisch auszuwerten und die Methode
auf unterschiedliche Zielregionen anzuwenden.
2. Welche Daten werden
verwendet?
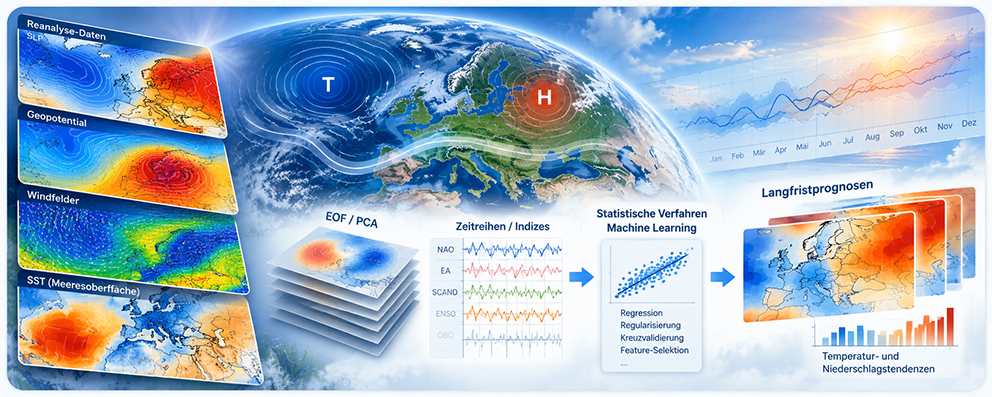
Das Verfahren untersucht monatliche Daten aus
mehreren Bereichen des Klimasystems. Als Prädiktoren
(Einflussgrößen, aus denen Hinweise auf die spätere
Entwicklung gewonnen werden sollen) dienen:
• Luftdruckdaten auf Meereshöhe an Gitterpunkten der
Nordhemisphäre mit einer räumlichen Auflösung von
2,5° × 2,5°;
• Geopotentialdaten der 200-hPa-Druckfläche, die
Informationen über die großräumige Strömung in
höheren Atmosphärenschichten liefern;
• Meeresoberflächentemperaturen, die den thermischen
Zustand der Ozeanoberfläche beschreiben.
Die Daten entstammen dem ERA-5-Datensatz des
European Centre for Medium-Range Weather Forecasts
(ECMWF).
Als zu prognostizirende Zielgrößen dienen vier klimatische Indizes für
den atlantisch-europäischen Raum, darunter die NAO.
Sie sollen wichtige Merkmale der großräumigen
Zirkulation in dieser Region zusammenfassen. Die
statistisch abgeleiteten Indexwerte bilden
anschließend eine Grundlage für die Berechnung der
erwarteten Druck- und Temperaturverteilung in
Europa.
Die Analyse wird für die jeweils letzten vier
Vormonate durchgeführt. Der Himalaya- und
Tibetbereich wird bei den Luftdruckdaten wegen
bekannter Unsicherheiten im Zusammenhang mit der
Reduktion auf Meereshöhe ausgeschlossen. Gebiete
südlich des Äquators werden in der beschriebenen
Analyse ebenfalls nicht berücksichtigt.
Verlauf der Methodik
Der Verlauf der Berechnungen des LRFS untergliedert sich in 4 Teilbereiche:
Korrelationsanalyse
Auswahl der Variablen
Hauptkomponentenanalyse
PLS-Regression
Berechnung der Vorhersagefelder
Einschub: Was ist der
Korrelationskoeffizient?
Der Korrelationskoeffizient (KK) ist ein Maß für die Stärke des linearen
Zusammenhanges zweier Datenreihen.
Der Wert dieses Koeffizienten ist eine dimensionslose Zahl und liegt immer
zwischen 1 und -1. Dabei bedeutet ein Wert von 1, dass ein perfekter
linearer Zusammenhang zwischen beiden Reihen vorliegt (je größer A, desto
größer B). Gleiches gilt bei -1, jedoch im umgekehrten Sinne (je größer A,
desto kleiner B). Ist überhaupt kein linearer Zusammenhang zwischen den
Datenreihen vorhanden, beträgt der Wert 0 (siehe Grafiken).
Der KK ist eine Maßzahl, die sich ausschließlich auf lineare Zusammenhänge
bezieht. Selbst wenn der Koeffizient niedrig bis null ist, kann dennoch
ein (nichtlinearer) Zusammenhang zwischen zwei Datensätzen vorhanden sein.
Obwohl atmosphärische Vorgänge in der Regel nicht linear sind, eignet sich
der KK dennoch um zumindest gewisse Beziehungen der Parameter
untereinander aufzudecken.
Um die Güte einer
Korrelation zu überprüfen, reicht die alleinige Kenntnis des KK nicht aus,
da dessen Aussagewert auch vom Umfang der Datenreihen abhängig ist. Ein
hoher KK bei einer geringen Anzahl von Fällen könnte auch zufälliger Natur
sein und eine sogenannte Scheinkorrelation vortäuschen. Um herauszufinden,
ob ein KK tatsächlich signifikant ist, d.h. ob der gefundene Zusammenhang
nicht nur in der Stichprobe existiert, sondern sich auch verallgemeinern
lässt, führt man einen Signifikanztest durch.
3. Die vier
Schritte des Verfahrens Schritt I:
Korrelationsanalyse
Zunächst wird geprüft, wie stark die monatlichen
Werte der meteorologischen Prädiktoren an den
einzelnen Gitterpunkten statistisch mit den
Zielindizes des jeweils folgenden Monats
zusammenhängen. Dafür wird der
Korrelationskoeffizient berechnet. Er beschreibt die
Stärke und Richtung eines linearen Zusammenhangs:
Ein Wert nahe +1 steht für einen starken positiven,
ein Wert nahe −1 für einen starken negativen
linearen Zusammenhang. Ein Wert nahe 0 weist auf
keinen ausgeprägten linearen Zusammenhang hin;
nichtlineare Beziehungen können damit allerdings
unentdeckt bleiben.
Diese Berechnung wird getrennt für Luftdruck,
200-hPa-Geopotential und Meeresoberflächentemperatur
sowie für die betrachteten Vormonate durchgeführt.
Da dabei sehr viele Gitterpunkte und Datensätze
ausgewertet werden, erfolgt dieser Arbeitsschritt
programmgesteuert.
Schritt II:
Auswahl der Variablen
Im nächsten Schritt werden diejenigen Variablen
ausgewählt, deren absoluter Korrelationskoeffizient
mit einem Zielindex mindestens 0,35 beträgt. Dieser
Schwellenwert ist ein festgelegtes Auswahlkriterium
des Verfahrens. Er dient dazu, die große Zahl
möglicher Einflussgrößen auf Variablen mit einem
vergleichsweise deutlichen linearen Zusammenhang zu
begrenzen. Die Auswahl wird für die drei
Prädiktorgruppen vorgenommen; die ausgewählten
Variablen werden anschließend für die weiteren
Berechnungen gespeichert.
Ein Korrelationswert allein beweist jedoch weder
einen ursächlichen Zusammenhang noch eine
zuverlässige Vorhersage. Bei sehr vielen
gleichzeitig geprüften Variablen müssen außerdem
Stichprobenumfang, zeitliche Abhängigkeiten der
Daten und die Vielzahl der durchgeführten Tests bei
der statistischen Bewertung berücksichtigt werden.
Schritt III:
Hauptkomponentenanalyse (PCA)
Die Korrelationsanalyse kann eine große Zahl
räumlich zusammenhängender Variablen liefern. Viele
davon enthalten ähnliche Informationen, weil
benachbarte Gitterpunkte häufig vergleichbare
Entwicklungen zeigen. Um diese Informationsfülle
übersichtlicher und statistisch handhabbarer zu
machen, wird auf die ausgewählten Variablen eine
Hauptkomponentenanalyse (Principal Component
Analysis, PCA) angewendet.
Die PCA fasst die Informationen mehrerer
ursprünglicher Variablen in wenigen neu gebildeten
Größen, den Hauptkomponenten, zusammen. Dadurch
können Redundanzen verringert und zusammengehörige
räumliche Muster kompakter beschrieben werden. Die
Analyse erfolgt getrennt nach Prädiktorgruppe und
Vormonat. Die so gewonnenen Hauptkomponenten werden
anschließend als Eingangsgrößen für das
Regressionsmodell verwendet.
Schritt IV:
PLS-Regression Berechnung der Prognosefelder
Im letzten statistischen Modellierungsschritt werden
die Hauptkomponenten mit einer PLS-Regression
(Partial Least Squares) ausgewertet. Dieses
Regressionsverfahren bildet Kombinationen der
Eingangsgrößen, die für die Erklärung
beziehungsweise Schätzung der Zielgrößen besonders
relevant sind. Aus dem Modell werden
Regressionskoeffizienten abgeleitet, mit denen die
Anomalien der Zielindizes für den Prognosemonat
geschätzt werden.
Schritt V:
Berechnung der Prognosefelder
Die prognostizierten Indexanomalien dienen
anschließend als Grundlage, um die erwarteten
Luftdruck- und Temperaturverteilungen zu berechnen.
Diese Berechnung erfolgt mithilfe einer
multivariaten Regression für Gitterpunkte im Abstand
von 5° × 5°. Für Deutschland werden die Ergebnisse
abschließend in verständliche Witterungskategorien
eingeteilt.
4.
Wie werden die Prognosen dargestellt?
Die Temperaturprognosen für Deutschland werden in
fünf Kategorien zusammengefasst: „sehr kalt“,
„kalt“, „normal“, „mild“ und „sehr mild“. Für den
Niederschlag werden drei Kategorien verwendet:
„trocken“, „normal“ und „nass“. Diese Begriffe
beziehen sich auf die erwartete Abweichung vom
klimatologischen Vergleichswert für den betrachteten
Zeitraum und nicht darauf, dass jeder einzelne Tag
entsprechend ausfallen muss.
Die Kategorien beschreiben somit eine großräumige
Tendenz für den jeweiligen Prognosezeitraum. Sie
sind keine detaillierte Vorhersage des Wetters an
einzelnen Tagen oder Orten. Auch innerhalb eines als
mild eingestuften Monats können kalte Phasen
auftreten; ebenso bedeutet die Kategorie „nass“
nicht, dass es durchgehend regnet.
5. Möglichkeiten und
Grenzen
Das LRFS nutzt historische statistische
Beziehungen zwischen großräumigen meteorologischen
Mustern und späteren Witterungsindizes. Sein Ansatz
besteht darin, mögliche Vorhersagesignale aus
verschiedenen Regionen und atmosphärischen
beziehungsweise maritimen Größen gemeinsam zu
untersuchen. Die statistischen Zusammenhänge können
sich jedoch im Laufe der Zeit verändern und sind
nicht in jeder Jahreszeit oder Region gleich
ausgeprägt.
Wie zuverlässig eine Prognose tatsächlich ist,
lässt sich deshalb nicht allein aus den gefundenen
Korrelationen oder aus dem Aufbau des Modells
ableiten. Dafür müssen die Vorhersagen systematisch
anhand geeigneter Verifikationsverfahren geprüft und
mit einer Referenz, beispielsweise der Klimatologie,
verglichen werden. Langfristprognosen geben
Wahrscheinlichkeiten und Tendenzen wieder; sie
erlauben keine sichere Festlegung des konkreten
Wetterablaufs über Wochen oder Monate.
Eine weitere Abhandlung des beschriebenen Verfahrens
ist als pdf-Datei
abrufbar (aktualisiert).
Vor- und Nachteile
liefert nachweißlich mit eine der stabilsten und
günstigsten Werte im Bereich Langfristprognose
weiter ausbaufähig durch Hinzuziehen anderer
Parameter, z.B. Eis- und
Schneebedeckungsgrad, stratosphärischen Parametern usw.
durch primäre Prognose der Indices sind Vorhersagen
für größere Areale möglich
Prognosen klar definiert und dadurch problemlos
verifizierbar
aus Art der prognostizierten Klasse lassen sich
andere Größen, wie z. B. Anzahl der Sommer- oder
Frosttage berechnen
homogene, langjährige Datenreihen sind für ein
Prognosegebiet notwendig
Signifikanzgebiete physikalisch oftmals nicht
erklärbar → daher Scheinkorrelationen (unechte
Zusammenhänge) nicht auszuschließen
eventuelle Instabilität bei den Prognosen d.h.
Änderungen einer Prognose im Verlauf der Monate
nicht selten → wird durch die
Hauptkomponentenanalyse aber soweit wie
möglich reduziert
Für weitere Fragen steht der Autor per
Mail
oder Formular gern zur Verfügung.


 abrufbar (aktualisiert).


 liefert nachweißlich mit eine der stabilsten und
günstigsten Werte im Bereich Langfristprognose
 homogene, langjährige Datenreihen sind für ein
Prognosegebiet notwendig